Chuyên gia AI tin nhân loại có thể diệt vong trong 10 năm tới

Nhà nghiên cứu Nate Soares cho rằng AI có hơn 50% khả năng hủy diệt nhân loại trong thập kỷ tới, đến mức ông ngừng đóng góp vào quỹ hưu trí.

Một tuyên bố gây chú ý trong giới công nghệ gần đây đến từ Nate Soares, nhà nghiên cứu học máy kiêm Chủ tịch Viện Nghiên cứu Trí tuệ Máy móc (MIRI). Trong podcast The Most Interesting Thing in AI của tạp chí The Atlantic, ông cho biết tin vào khả năng trí tuệ nhân tạo (AI) gây ra thảm họa diệt vong cho nhân loại đến mức đã dừng đóng góp vào tài khoản hưu trí. Theo Soares, xác suất kịch bản này xảy ra trong 10 năm tới vượt 50%. Ông từng có quỹ hưu trí 401(k) trong thời gian làm việc tại Google, nhưng không bổ sung tiền vào tài khoản suốt khoảng một thập kỷ qua.
ai.png
Nate Soares, Chủ tịch Viện Nghiên cứu Trí tuệ Máy móc, đánh giá AI có nguy cơ gây thảm họa cho nhân loại trong thập kỷ tới.

Dù đưa ra dự báo bi quan, Soares nhấn mạnh thảm họa không phải kết cục chắc chắn và ông vẫn đang nỗ lực để ngăn chặn viễn cảnh đó. Nhà nghiên cứu này là một trong những gương mặt nổi bật của nhóm cảnh báo về rủi ro AI, đồng thời có mối quan hệ hợp tác với Eliezer Yudkowsky, người đồng sáng lập MIRI. Những cảnh báo về nguy cơ AI vượt khỏi tầm kiểm soát của nhóm từng thu hút sự chú ý lớn từ truyền thông và giới hoạch định chính sách. Tuy nhiên, các ý kiến phản biện cho rằng giới nghiên cứu chưa đạt được đồng thuận về khả năng xảy ra một thảm họa như vậy, đặc biệt là những dự báo gắn với mốc thời gian cụ thể.

Trên thực tế, AI đã gây ra nhiều rủi ro đáng quan tâm mà không cần đạt đến cấp độ siêu trí tuệ. Công nghệ này có thể bị lợi dụng để tạo nội dung lừa đảo, thao túng người dùng hoặc hỗ trợ các hành vi gây hại. Những hệ thống AI cũng từng bị chỉ trích vì tác động tiêu cực đến nhóm người dùng dễ tổn thương. Đây là các vấn đề hiện hữu, đòi hỏi biện pháp kiểm soát và trách nhiệm rõ ràng từ doanh nghiệp phát triển công nghệ. Vì vậy, việc quá tập trung vào kịch bản AI hủy diệt nhân loại trong tương lai xa có thể khiến một số nguy cơ đang diễn ra bị xem nhẹ.
tj.png
Những tranh luận về rủi ro AI ngày càng tập trung vào cả nguy cơ dài hạn và các tác động tiêu cực đang xuất hiện.

Phát biểu của Soares cũng đặt ra câu hỏi về cách mỗi người đánh giá rủi ro AI trong đời sống. Dự báo của một chuyên gia, dù có kinh nghiệm nghiên cứu, không đồng nghĩa với kết luận đã được kiểm chứng hay quan điểm chung của toàn ngành. Các con số xác suất như mức trên 50% cần được nhìn nhận trong bối cảnh đây là đánh giá cá nhân, thay vì dự báo khoa học đã đạt đồng thuận. Tương tự, quyết định ngừng tiết kiệm hưu trí của Soares phản ánh niềm tin riêng của ông, không phải khuyến nghị tài chính dành cho số đông.

Trong khi tương lai của AI vẫn còn nhiều tranh luận, các kế hoạch tài chính cá nhân nên dựa trên nhu cầu thực tế và khả năng dự phòng dài hạn. Nếu kịch bản xấu nhất không xảy ra, việc ngừng tích lũy có thể để lại hệ quả đáng kể khi về già. Ngược lại, những rủi ro AI đang hiện hữu vẫn cần được theo dõi và xử lý bằng các giải pháp cụ thể, thay vì chỉ tập trung vào viễn cảnh tận thế.

Mời quý độc giả xem thêm video: Anthropic mở đường IPO định giá tới 2.000 tỷ USD: Doanh thu bùng nổ, lỗ khổng lồ, cảnh báo AI vượt kiểm soát và cam kết hạ tầng choáng váng.

Vì sao mã OTP qua SMS không còn đủ an toàn?

Mã OTP qua SMS có thể bị đánh cắp bằng thủ đoạn chiếm SIM hoặc lừa đảo trực tuyến. Chuyên gia khuyến nghị chuyển sang phương thức xác thực an toàn hơn.

Mã OTP qua tin nhắn SMS từng là lớp bảo vệ quen thuộc khi đăng nhập tài khoản ngân hàng, mạng xã hội hay xác nhận giao dịch trực tuyến. Tuy nhiên, trước sự gia tăng của các hình thức lừa đảo công nghệ cao, phương thức này đang bộc lộ nhiều hạn chế. Kẻ gian có thể chiếm quyền sử dụng số điện thoại, giả mạo trang đăng nhập hoặc lừa người dùng tự cung cấp mã xác thực. Theo Cơ quan An ninh mạng và Cơ sở hạ tầng Mỹ (CISA), xác thực qua SMS có nguy cơ bị tấn công thông qua lừa đảo trực tuyến, chiếm đoạt SIM và khai thác lỗ hổng trong hệ thống viễn thông.

ban-4846.png
OTP qua SMS có thể bị đánh cắp nếu người dùng trở thành nạn nhân của chiêu trò giả mạo website hoặc chiếm đoạt SIM.

Sam Altman cảnh báo AI có thể vượt tầm kiểm soát an ninh mạng

AI ngày càng có khả năng phát hiện lỗ hổng bảo mật phức tạp, đặt ra thách thức lớn cho phương pháp phòng thủ mạng và vá lỗi truyền thống.

Sự phát triển nhanh chóng của trí tuệ nhân tạo (AI) đang đặt ra những câu hỏi lớn về tương lai an ninh mạng. Các mô hình AI có thể hỗ trợ tìm kiếm lỗ hổng trong phần mềm với tốc độ và quy mô đáng kể, khiến việc bảo vệ hệ thống trước những cuộc tấn công ngày càng phức tạp. Những cảnh báo được gán cho Sam Altman, CEO OpenAI, phản ánh mối lo ngại rằng năng lực AI có thể vượt quá khả năng ứng phó của các phương pháp bảo mật hiện nay.

an.png
AI có thể hỗ trợ chuyên gia phân tích mã nguồn và phát hiện những lỗ hổng bảo mật khó nhận biết bằng phương pháp thông thường.

ChatGPT, Gemini, Claude có thể khóa tài khoản vì lý do gì?

Tài khoản ChatGPT, Gemini và Claude có thể bị khóa vì vi phạm chính sách. Người dùng cần biết cách kháng nghị và sao lưu dữ liệu để tránh mất thông tin.

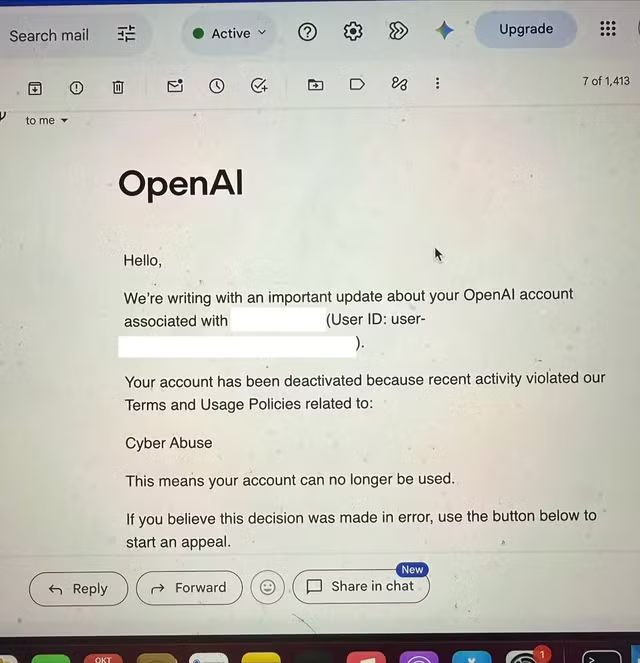
Mới đây, một nhà nghiên cứu bảo mật sử dụng tài khoản có tên log4j cho biết nhận được email từ OpenAI thông báo tài khoản ChatGPT bị vô hiệu hóa vì lý do “Cyber Abuse”, tức lạm dụng an ninh mạng. Trước đó, người này đăng các bài viết về việc giành quyền quản trị trên chiếc TV Samsung đời 2025 để tìm hiểu thiết bị thu thập dữ liệu. Log4j khẳng định không sử dụng OpenAI để tìm kiếm hay khai thác lỗ hổng. Tuy nhiên, đến ngày 28/10, OpenAI chưa xác nhận hoạt động cụ thể khiến tài khoản bị gắn cờ. Vụ việc làm dấy lên câu hỏi về ranh giới giữa nghiên cứu hợp pháp và hành vi vi phạm chính sách AI.

o-8936.png
Email thông báo tài khoản ChatGPT bị vô hiệu hóa với lý do “Cyber Abuse” trong vụ việc được nhà nghiên cứu log4j chia sẻ. (Ảnh: cybersport)